Begriffsklärungen rund um AI, Infrastruktur und Full-Stack – alphabetisch, Eintrag für Eintrag.
API
Eine API (Application Programming Interface) ist eine klar definierte Schnittstelle, über die Programme miteinander sprechen – typischerweise per HTTP mit Anfragen und Antworten im JSON-Format. Für KI-Agents sind APIs oft die Brücke zur Außenwelt: Wetterdaten abrufen, Tickets anlegen, Dateien schreiben oder Modelle aufrufen. Viele „Tools“ eines Agents sind fachlich nichts anderes als gekapselte API-Aufrufe bzw. Python-Funktionen, die dem LLM als Schema bekannt gemacht werden.
Caddy ist ein moderner, performanter Webserver und Reverse Proxy. Er steuert das Routing meiner verschiedenen Webprojekte, bündelt unterschiedliche Dienste unter sauberen Domains und übernimmt automatisch die HTTPS-Verschlüsselung. Für AI Labs eignet er sich hervorragend, um neue KI-Anwendungen, FastAPI-Services, Gradio-Apps oder Agenten schnell, sicher und produktionsnah bereitzustellen. Wachsen daraus unternehmenskritische Plattformen, kommen meist zusätzliche Komponenten zum Einsatz. Geht es speziell um intelligentes Routing zwischen verschiedenen LLM-Providern, Prompt-Management oder AI-spezifische Policies, setzt man auf spezialisierte AI Gateways.
Das Context Window ist die begrenzte Menge an Text (Tokens), die ein Sprachmodell in einem Durchlauf gleichzeitig verarbeiten kann – Input und Output zusammen. Wird dieser Rahmen überschritten, muss Kontext gekürzt, zusammengefasst oder über Retrieval nachgeladen werden. Genau deshalb ist RAG so relevant: Statt alle Quellen auf einmal in das Fenster zu pressen, gelangen nur die relevanten Passagen zum Modell.
Docker packt Anwendungen mit ihren Abhängigkeiten in Container – isoliert, portabel und reproduzierbar. Lokal und auf dem Server läuft dieselbe Umgebung; das reduziert „bei mir geht’s“-Probleme und macht Deployments für Webdienste, APIs und KI-Demos vorhersehbar. In schlanken Full-Stack-Setups ist Docker typischerweise die Isolationsschicht unter Reverse Proxy und App-Prozessen.
Ein Embedding wandelt Text (oder andere Daten) in einen Zahlenvektor um, der semantische Bedeutung abbildet. Ähnliche Inhalte liegen im Vektorraum nah beieinander – so kann eine User-Frage mit Quelltexten verglichen werden, ohne dass exakte Wortübereinstimmung nötig ist. In RAG-Systemen werden Dokumente vorab eingebettet und in einer Vektordatenbank gespeichert; die Frage wird zur Laufzeit ebenfalls eingebettet und dient als Suchschlüssel. Mehr unter Data Factory · Vector Embedding.
Schlanke Schnittstelle, um KI-Modelle und Python-basierte Apps sofort in einen auswertbaren Web-Dienst zu verwandeln. Hervorragend geeignet für das Realtime-Streaming von Tokens (Wort-für-Wort-Ausgabe), automatische Datenvalidierung VOR dem Start rechenintensiven KI Codes und automatische Testumgebung (allerdings keine rein visuellen Prototypen, dafür wird dann zB Streamlit oder Gradio benötigt).
Git ist das Versionskontrollsystem für Code und Konfiguration; GitHub ist die Plattform dafür – Repositories, Reviews, Issues und Automatisierung. Zusammen ermöglichen sie nachvollziehbare Änderungen, Zusammenarbeit und reproduzierbare Deployments (z. B. über GitHub Actions). Für Prototypen und produktive Stacks ist das die Grundlage, um Infrastruktur und Anwendungscode kontrolliert weiterzuentwickeln.
Harness Engineering meint die Disziplin, einem Agenten die richtigen Werkzeuge in der richtigen Form bereitzustellen – und gefährliche oder unnötige Zugriffe wegzulassen. Dazu gehören Tool-Auswahl, klare Beschreibungen/Schemas, Guardrails und der Ablauf, in dem Tools geplant und ausgeführt werden. Der Agent wird dadurch handlungsfähig, bleibt aber in einem kontrollierten Rahmen. Mehr unter Single AI Agent Design · Tooling.
Human in the Loop (HITL) bedeutet, dass ein Mensch an kritischen Stellen im Agenten-Ablauf eingreift – etwa um Ergebnisse freizugeben, Pläne zu bewerten oder den nächsten Schritt freizuschalten. Statt vollständiger Autonomie liefert der Agent Vorschläge; der Mensch entscheidet über Erfolg, Abbruch oder Fortsetzung. Das erhöht Kontrolle und Sicherheit, besonders wenn Aktionen Nebenwirkungen haben können. In der Escape-Demo übernimmt der Nutzer genau diese Rolle als Game Master.
Kubernetes (K8s) orchestriert Container über Cluster hinweg: Scheduling, Skalierung, Health-Checks und Netzwerk. Sobald aus wenigen Diensten eine produktive Plattform mit Hochverfügbarkeit und horizontaler Skalierung wird, ersetzt es oft das manuelle Betreiben einzelner Container. Für frühe AI-Prototypen ist es meist Overkill – relevant wird es beim Übergang vom Lab zur Enterprise-Plattform.
LangChain ist ein Framework zum Bau von LLM-Anwendungen: Chains, Tools, Retriever, Prompt-Templates und Integrationen zu Modellen und Datenspeichern. Es beschleunigt typische Muster wie RAG, Tool-Calling und Agent-Schleifen, ohne alles von Grund auf selbst verdrahten zu müssen. Mehr unter Single AI Agent Design · Tooling.
LangGraph ergänzt das LangChain-Ökosystem um zustandsbehaftete Workflows als Graphen: Knoten, Kanten, Schleifen und Kontrolle über den Ablauf. Damit lassen sich Agenten mit klarer Steuerung, Persistenz und Verzweigungen bauen – über einfache lineare Chains hinaus.
Least Privilege bedeutet: nur so viele Rechte wie nötig – und keine darüber hinaus. Bei Agenten heißt das konkret, API-Keys, Tools und Datenzugriffe bewusst zu begrenzen, damit ein Agent nur das tun kann, was seine Aufgabe erfordert. Mit wachsenden „Agenten-Armeen“ wird diese Schlüssel- und Rechtevergabe zur zentralen Sicherheitsaufgabe; der Mensch bleibt Hüter und Entscheider. Mehr unter REST & External API Integration.
LLM steht für Large Language Model – ein großes Sprachmodell, das auf sehr großen Textmengen trainiert wurde und daraus Texte verstehen und erzeugen kann. Es liefert die generative Fähigkeit in Chatbots und RAG-Pipelines, kennt aber ohne zusätzlichen Kontext weder interne Dokumente noch aktuelle Unternehmensdaten. Deshalb ergänzt man LLMs oft mit Retrieval, Tools oder Fine-Tuning.
Der Prompt ist die Eingabe an das Sprachmodell: Aufgabe, Regeln, optionaler Kontext und die eigentliche Nutzerfrage. In RAG-Systemen wird der Prompt typischerweise aus Systemanweisung, retrieved Textstellen und User-Frage zusammengesetzt – damit das Modell die Antwort auf die bereitgestellten Quellen stützt, statt frei zu halluzinieren.
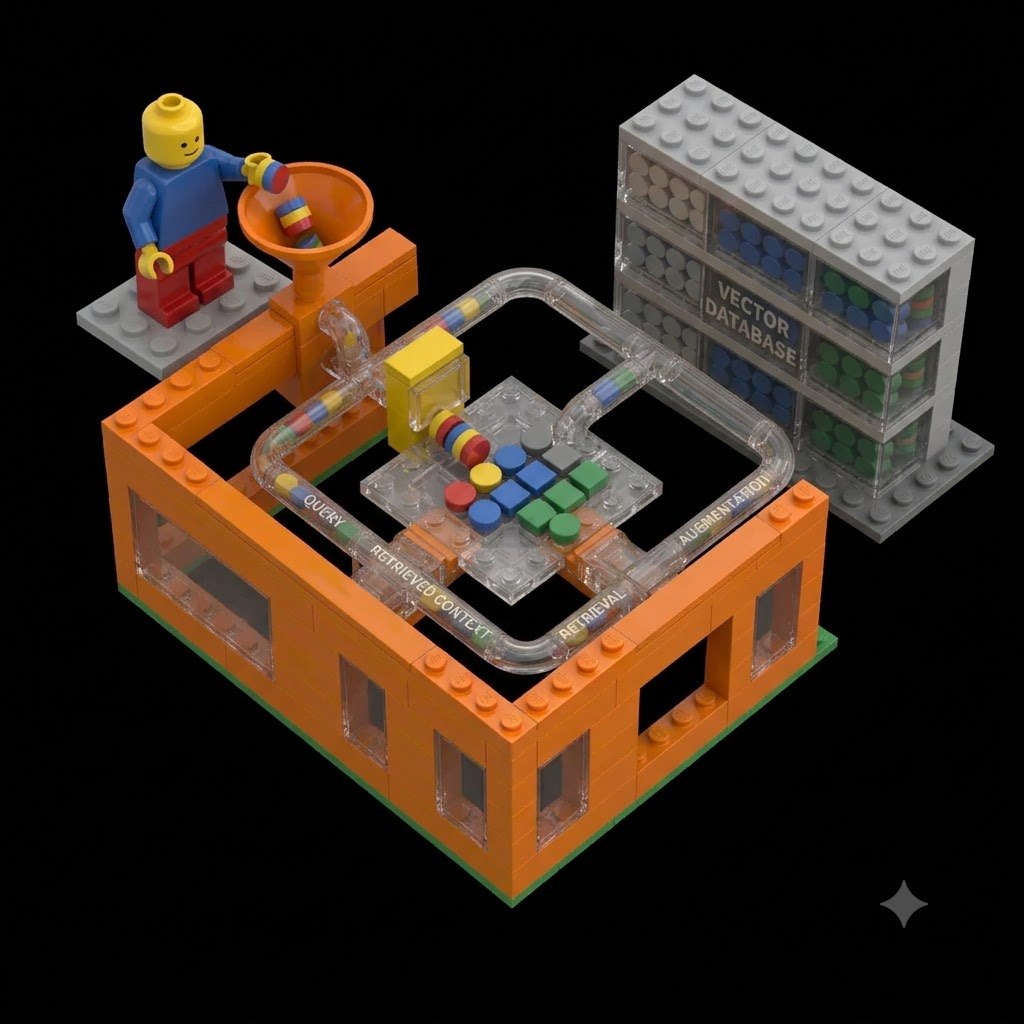
RAG (Retrieval-Augmented Generation) verbessert generative KI, indem Antworten auf eigenen Wissensquellen basieren – nicht nur auf Trainingsdaten oder Websuche. Zuerst sucht das System passende Textstellen (Retrieval), dann fließen diese zusammen mit der Frage in den Prompt (Augmentation), und erst danach erzeugt das LLM die Antwort (Generation). So bleibt das begrenzte Context Window nutzbar, selbst wenn die Gesamtdatenmenge riesig ist. Mehr dazu unter Context & Memory · RAG.
ReAct steht für Reason + Act: Das Modell plant und reflektiert (Reason), führt dann Aktionen über Werkzeuge aus (Act) und kann den Zyklus wiederholen. Im Gegensatz zu rein deterministischer Software bewertet der Agent die Situation semantisch und wählt Tools selbst. Vollautonome Varianten beobachten den Erfolg selbst; in vielen Demos – so auch unter Tooling – ersetzt Human in the Loop diese Bewertung. Mehr unter Single AI Agent Design · Tooling.
REST (Representational State Transfer) ist ein Architekturstil für Web-APIs: Ressourcen werden über URLs angesprochen, typischerweise mit HTTP-Methoden wie GET, POST, PUT oder DELETE und oft JSON als Datenformat. Viele öffentliche und kommerzielle Dienste folgen diesem Muster – von Live-Daten (z. B. Open Notify) bis zu großen Plattform-APIs. Mehr unter REST & External API Integration.
Der Retriever holt aus einer Wissensbasis – oft einer Vektordatenbank – die zum Query passendsten Dokumente oder Chunks. Typischerweise top‑k Treffer nach Ähnlichkeit der Embeddings. Er entscheidet damit, welcher Kontext überhaupt in den Prompt gelangt, und ist die Schaltstelle zwischen gespeichertem Wissen und dem LLM.
Ein SDK (Software Development Kit) ist eine vorgefertigte Programmbibliothek um eine API herum. Statt rohe HTTP-Aufrufe zu bauen, nutzen Entwickler und Agenten-Tools fertige Funktionen für Authentifizierung, Fehlerbehandlung und Datenstrukturen. Besonders bei umfangreichen APIs – etwa der YouTube Data API von Google – macht das den Zugriff deutlich eleganter. Mehr unter REST & External API Integration.
Streaming bedeutet, dass die Ausgabe eines LLM oder Agenten nicht erst am Ende, sondern Stück für Stück live angezeigt wird – Token für Token oder Ereignis für Ereignis (z. B. Tool-Aufrufe). Nutzer sehen so den Fortschritt sofort; Wartezeiten wirken kürzer, und Zwischenschritte wie Tool-Calls bleiben nachvollziehbar. In der YouTube-Demo wird der ReAct-Ablauf genau so sichtbar gemacht. Mehr unter REST & External API Integration.
Terraform ist ein Werkzeug für Infrastructure as Code: Server, Netzwerke, Cluster und Cloud-Ressourcen werden als deklarative Konfiguration beschrieben und versioniert ausgerollt. Änderungen sind nachvollziehbar und wiederholbar – wichtig, sobald Prototypen zu produktiven Umgebungen wachsen und manuelle Klicks im Cloud-Dashboard nicht mehr ausreichen.